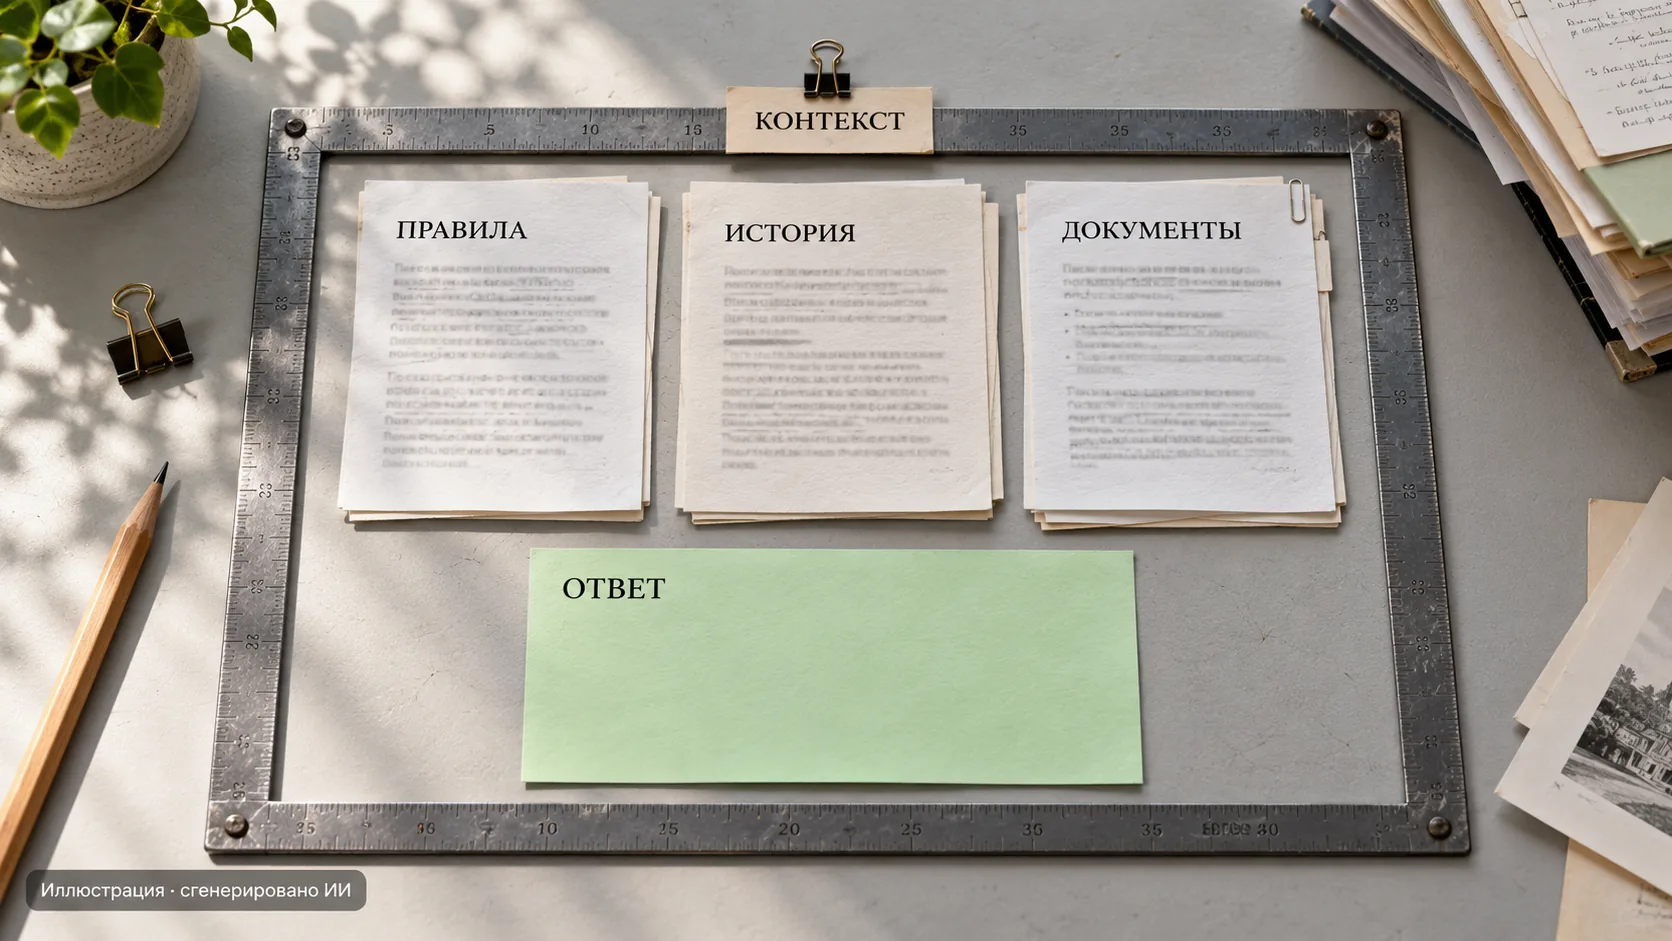
Контекстное окно модели — это объём информации, с которой нейросеть может работать при подготовке ответа. В него попадают текущий вопрос, переданная история, инструкции, документы и результаты инструментов. Это не контекстное меню Windows и не размер окна браузера: речь о рабочем пространстве языковой модели, которое измеряется в токенах.
Большое окно позволяет передать длинный договор, несколько файлов проекта или продолжительный диалог. Но оно не гарантирует, что модель одинаково хорошо использует каждую строку. Ниже разберём, как проверить размер контекста, оставить место для ответа и выбрать между длинным запросом, сокращением истории и поиском по документам.
Что такое контекстное окно простыми словами
Представьте рабочий стол: на нём лежат условия задачи и материалы, которые нужны прямо сейчас. Библиотека, из которой вы принесли книги, намного больше стола. Так и у модели: сведения, усвоенные при обучении, не равны документам, которые ей передали в конкретном запросе.
История в интерфейсе может выглядеть бесконечной, а активный контекст остаётся ограниченным. Программа способна хранить весь разговор в базе, но отправлять модели только часть сообщений или их краткое содержание. Поэтому «сообщение есть в чате» и «модель сейчас получила его полностью» — разные утверждения.
Токен — единица представления данных для модели. Одно слово может занимать несколько токенов; код, русский текст, таблицы и изображения учитываются по-разному. Переводить лимит в страницы через постоянный коэффициент ненадёжно. Основы подсчёта разобраны в статье «Токены и лимиты: как считать и экономить».
Что занимает место в контексте
- Инструкции и задача. Роль, правила, формат результата и новый вопрос пользователя.
- История. Предыдущие сообщения, ответы модели и необходимые промежуточные результаты.
- Документы. Текст файлов, извлечённые фрагменты, изображения и другие поддерживаемые данные.
- Инструменты. Описания доступных функций, их параметры, результаты вызовов и журналы.
- Генерация. Ответ и рассуждения — в зависимости от того, как конкретная модель учитывает вход и выход.
Из-за служебных материалов небольшой вопрос может оказаться частью большого запроса. Например, помощник для сайта получает короткое «проверь заказ», но вместе с ним — правила магазина, схему инструментов, историю и сведения о покупке. Длинный ответ API тоже становится частью следующих шагов, если приложение возвращает его модели целиком.
Неизменяемый набор правил полезно держать компактным и однозначным. Как сформулировать его без лишних повторов, рассказываем в материале о системном промпте. При этом экономить место удалением важных ограничений — плохая замена нормальной организации запроса.
Размер контекстного окна и длина ответа — не одно и то же
Перед подключением смотрите три вещи: допустимый вход, максимальный выход и правила общего бюджета. Одни API разделяют входной и выходной лимиты, другие учитывают их в общем окне. Поведение зависит от модели и версии, а не только от названия провайдера.
Два примера из документации, проверенной 21 октября 2026 года:
| Пример | Что указано в справочнике | Практический вывод |
|---|---|---|
| Claude Sonnet 5.5 | Контекст до 1 млн токенов; выход одного запроса до 128 тыс. токенов | Большое окно не означает ответ на миллион токенов |
| Gemini 4 Argon | Окно 1 048 576 токенов разделяют вход, рассуждения и выход | Чем больше вход, тем меньше остаётся места для генерации |
Это примеры устройства лимитов, а не сравнение качества моделей. Google отдельно отмечает другую схему у предыдущих поколений Gemini с раздельными бюджетами входа и выхода. Нельзя переносить параметры одной версии в другую без проверки справочника.
Доступный в приложении объём также может быть меньше возможностей базовой модели: часть места занимает система, а сервис применяет собственные ограничения. Параметр максимального ответа задаёт верхнюю границу генерации, а не обещание, что модель обязательно заполнит её.
Как рассчитать бюджет запроса
Возьмём условную модель с общим окном 128 000 токенов. Это учебный пример, а не тариф или настройка конкретного сервиса. Заранее выделим место под ответ и небольшой запас:
| Часть запроса | Плановый объём |
|---|---|
| Правила и текущая задача | 4 000 |
| Описания инструментов | 6 000 |
| Нужная история | 18 000 |
| Документы | 88 000 |
| Ответ | 8 000 |
| Запас | 4 000 |
Для документов осталось 128 000 − 4 000 − 6 000 − 18 000 − 8 000 − 4 000 = 88 000 токенов. Если включены рассуждения, их бюджет тоже нужно учесть по правилам выбранной модели. Иначе большой вход поместится, а на итоговый ответ места окажется недостаточно.
Предварительный счётчик должен соответствовать модели и учитывать структуру запроса. У провайдеров есть специальные методы подсчёта; после запроса полезно смотреть статистику расхода. Однако счётчик может поддерживать не все серверные инструменты и способы передачи файлов. Например, документация Claude перечисляет ограничения своего Token Counting API. Проверяйте именно свой сценарий.
Почему миллион токенов не означает идеальную память
Вместимость и качество использования информации — разные характеристики. Модель может принять большой массив, но пропустить нужное условие, выбрать похожий фрагмент или не связать два удалённых друг от друга пункта. Дополнительные нерелевантные материалы усложняют задачу вместо того, чтобы помогать.
Исследование Lost in the Middle, опубликованное в 2023 году, показало зависимость качества поиска ответа от положения важной информации в длинном контексте на проверенных тогда моделях и задачах. Это не готовый рейтинг моделей 2026 года. Работа полезна как основание проверять расположение сведений, а не полагаться только на рекламируемую длину окна.
Для своего помощника можно подготовить один документ с контрольным условием и размещать это условие в начале, середине и конце. Затем задавать одинаковый вопрос и проверять ответ вместе со ссылкой на нужный раздел. Отдельно протестируйте похожие, но устаревшие условия: простое повторение найденного числа ещё не доказывает правильный выбор источника.
Что делать, когда контекст заканчивается
Универсального поведения нет. API может отклонить слишком большой вход или остановить генерацию на границе окна. Клиентское приложение может заранее сократить историю. Например, Claude документирует ошибку для входа, который сам по себе больше окна, и отдельное поведение при достижении границы во время ответа на новых моделях.
Поэтому сообщение об обрыве не всегда означает сбой сети. Проверяйте причину остановки, входной объём и настройки ответа. Не стоит бесконечно повторять тот же слишком большой запрос: его размер от этого не изменится.
Для длинной работы помогает сводка состояния: цель, принятые решения, ограничения, ссылки на файлы и следующий шаг. Сжатие истории, или compaction, заменяет старые сообщения кратким содержанием. У Claude есть серверные механизмы такой обработки, но поддержка и условия зависят от модели и платформы. Любая сводка может потерять детали, поэтому критичные значения и первоисточники нужно сохранять отдельно.
Когда нужен длинный контекст, а когда — RAG
| Ситуация | С чего начать |
|---|---|
| Один договор нужно сопоставить с приложениями | Передать связанный набор документов, если он помещается и качество проверено |
| Нужно отвечать по большой обновляемой базе знаний | Искать релевантные фрагменты и передавать их модели |
| Длинная работа над проектом | Сводка состояния, актуальные файлы и только нужные результаты инструментов |
| Важные сведения распределены между несколькими разделами | Проверить многошаговый поиск и связи, а не брать первый похожий отрывок |
RAG — подход, при котором приложение сначала находит материалы, а затем использует их при генерации ответа. Он сокращает вход, но добавляет отдельный риск: поиск может не найти нужный документ. Большое окно и RAG можно сочетать — например, извлекать несколько связанных разделов, а не одну короткую цитату. Подробнее — в статье о RAG простыми словами.
Как длинный контекст влияет на расходы и память
В API большой вход увеличивает число обрабатываемых токенов; стоимость зависит от тарифа, кеширования и модели. Повторять весь архив в каждом запросе часто незачем. Кеширование может изменить цену повторяемого входа, но не превращает его в данные «за пределами окна»: закешированные токены тоже занимают контекст. Механизм разобран в статье о кешировании промптов.
При локальном запуске растёт потребность в памяти для рабочих данных, в частности KV-кеша — сохранённых промежуточных значений для обработки последовательности. Расход зависит от архитектуры, движка и настроек; одинаковое число токенов не означает одинаковое количество гигабайт у разных моделей. Размер файла весов не описывает всю память, нужную во время работы.
Выбирайте контекст под задачу, а не по максимальному числу в карточке. Измерьте реальный запрос, оставьте бюджет для ответа, уберите повторения и проверьте качество на своих документах. Если важные сведения перестали помещаться, организуйте историю и поиск — простая смена модели на вариант с более длинным окном не устраняет все причины ошибок.
Частые вопросы
Это рабочий объём информации, доступной модели при подготовке ответа. В него входят переданные инструкции, история, документы и результаты инструментов; правила учёта генерации зависят от модели и API. Размер измеряют в токенах.
Нет. Максимальный выход проверяют отдельно от размера контекста. У модели может быть большой входной бюджет и намного меньший предел ответа, либо общий бюджет для входа, рассуждений и выхода.
Нет. Кеширование может изменить стоимость и скорость обработки повторяемого входа, но закешированные токены продолжают занимать контекст. Для уменьшения активного объёма нужны отбор материалов, сокращение истории или другие механизмы.
Не всегда. Для связанного набора документов удобен длинный запрос, а для большой обновляемой базы знаний полезен поиск релевантных материалов. Подходы можно сочетать. Качество нужно проверять как у поиска, так и у итогового ответа.
Источники
- 1.Anthropic — устройство контекстного окна и лимиты моделейhttps://platform.claude.com/docs/en/build-with-claude/context-windows
- 2.Anthropic — предварительный подсчёт токенов и ограничения методаhttps://platform.claude.com/docs/en/build-with-claude/token-counting
- 3.Anthropic — сжатие истории разговораhttps://platform.claude.com/docs/en/build-with-claude/compaction
- 4.Google — длинный контекст и общий бюджет Gemini 4https://ai.google.dev/gemini-api/docs/long-context
- 5.Google — токенизация и статистика расходаhttps://ai.google.dev/gemini-api/docs/tokens
- 6.Hugging Face — стратегии KV-кеша и расход памятиhttps://huggingface.co/docs/transformers/kv_cache
- 7.Lost in the Middle — исследование использования длинного контекста, 2023https://arxiv.org/abs/2307.03172