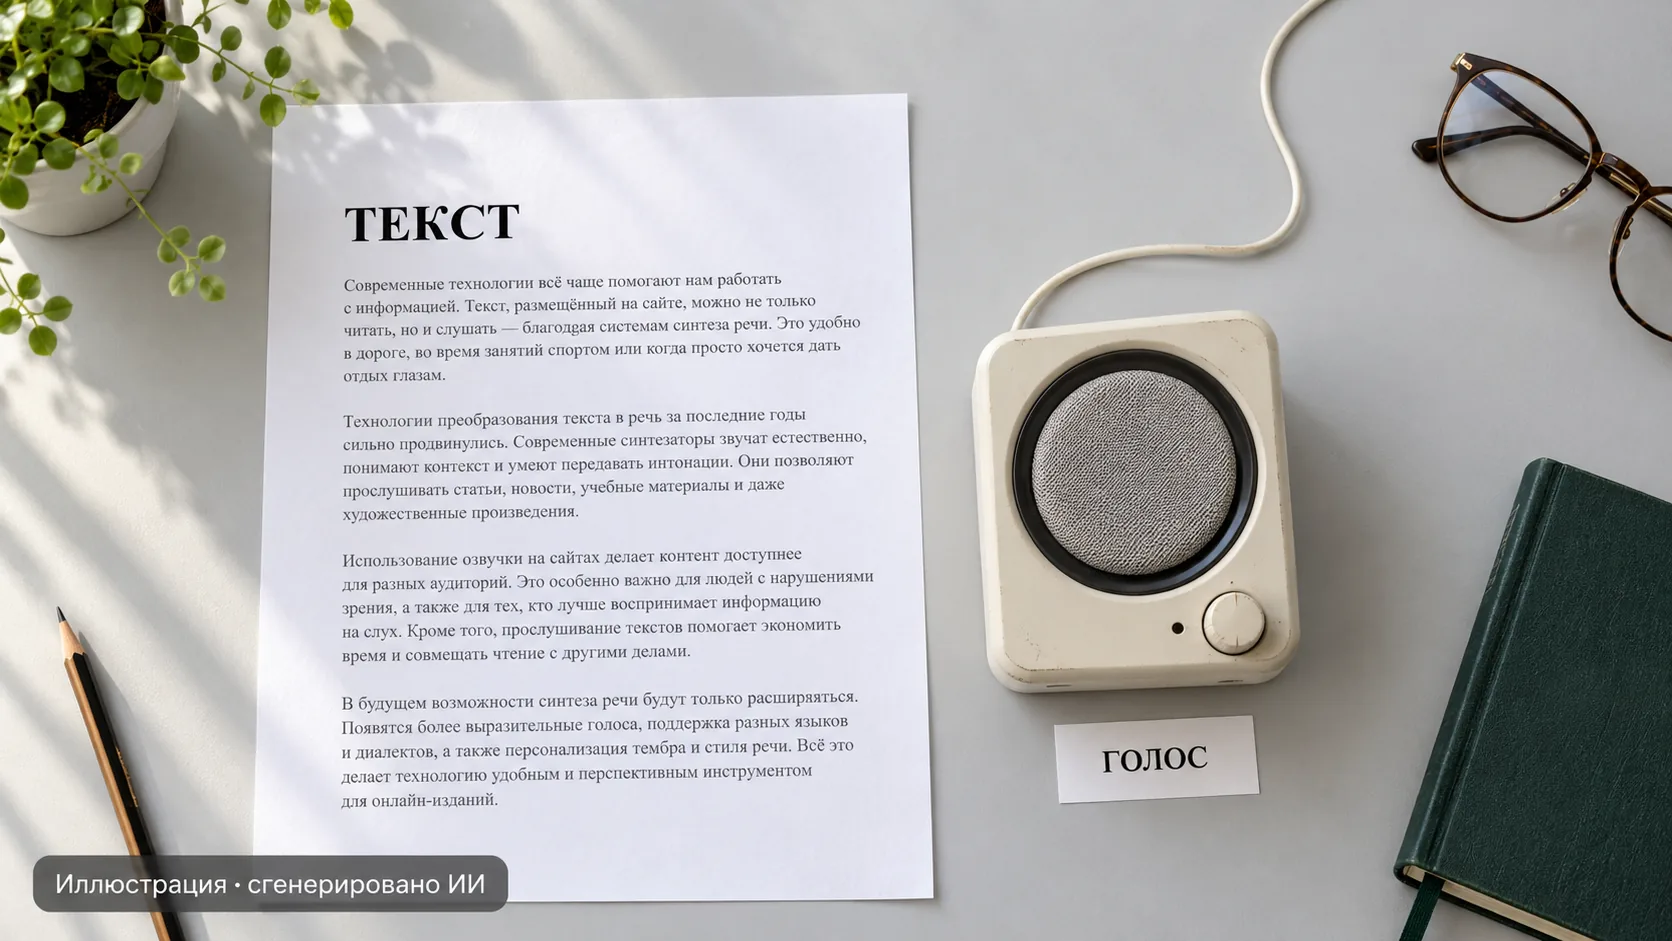
Нейросеть для озвучки текста превращает готовый сценарий в аудиозапись: статью можно слушать, инструкцию — включить в обучающий ролик, а уведомление — произнести голосом. Эта технология называется TTS, от английского text-to-speech — «текст в речь». Для нескольких записей достаточно веб-сервиса; для регулярной озвучки публикаций удобнее программный интерфейс API.
Ниже разберём выбор сервиса, подготовку русского текста, стоимость и первый API-запрос. Возможности и тарифы проверены 20 октября 2026 года. Универсального «самого живого голоса» здесь не будет: выразительная реклама, длинная статья и короткий ответ голосового помощника требуют разных настроек.
Что умеет синтез речи и чем отличается от транскрибации
В TTS на вход поступает текст, а на выходе получается звук. Обратная задача — извлечь текст из записи разговора — называется распознаванием речи. Её мы разбирали в статье о транскрибации аудио через ИИ. Одна платформа может предлагать обе функции, но это разные запросы, ограничения и расходы.
Для сайта есть три понятных применения: аудиоверсия заметки, озвученная инструкция по настройке и короткие реплики интерфейса. В первых двух случаях выгодно один раз подготовить файл и раздавать его посетителям. В живом диалоге важнее задержка ответа: там длинная предварительная генерация уже не подходит.
Озвучка не исправляет содержание. Если в сценарии неверная дата или команда, красивый голос произнесёт ту же ошибку. Сначала редактируем и проверяем текст, затем делаем аудио. Подход к подготовке исходника описан в заметке про промпт для текста.
Какие сервисы попробовать для русской озвучки
| Вариант | Как начать | На что смотреть |
|---|---|---|
| Yandex SpeechKit | Выбрать голос и подключить API | Версию API, формат аудио и единицу тарификации |
| SaluteSpeech | Попробовать синтез на портале или в приложении для Windows и macOS; затем перейти к API | Доступный пакет услуг, голоса и подходящий способ синтеза |
| ElevenLabs | Создать озвучку в веб-интерфейсе; для интеграции использовать API | Модель, расход кредитов, условия коммерческого использования и оплаты |
| SpeechSynthesis в браузере | Воспроизвести текст средствами Web Speech API | Голоса на устройстве посетителя; это не готовый MP3-файл |
SpeechKit удобен как пример серверного подключения с отдельной оплатой объёма. SaluteSpeech даёт путь без программирования и программный доступ. У ElevenLabs есть несколько семейств моделей: в текущем справочнике представлены Eleven v4 и v4 Turbo, а также Multilingual v2 и Flash v2.5. Поддержка русского языка есть, но конкретный голос и выбранную модель нужно слушать на своём материале.
Это сравнение способов работы, а не рейтинг качества: мы не проводили одинаковый слепой тест голосов. Для зарубежного сервиса до переноса всего процесса проверьте доступность регистрации и оплаты для своего аккаунта. Поддержка русского языка сама по себе не гарантирует возможность оплатить подписку российской картой.
Как выбрать голос: тест на одном фрагменте
Возьмите 500–1000 знаков из будущей публикации и дайте всем кандидатам один исходник. Включите фамилию, дату, цену, английское название и длинное предложение. Для технического блога полезны слова PostgreSQL, API и названия моделей: на них быстрее обнаруживается неудобное произношение.
- Разборчивость. Слова и окончания не пропадают, числа понятны без взгляда в текст.
- Паузы. Слушатель различает заголовок, перечисление и новый абзац.
- Стабильность. Голос не меняет манеру посередине и одинаково произносит название продукта.
- Темп. Инструкция остаётся понятной, даже если в ней несколько действий подряд.
- Цена исправления. Можно перегенерировать один фрагмент, сохранив остальную запись.
Не выбирайте голос только по демонстрационной фразе провайдера. Короткое приветствие почти ничего не говорит о том, как он прочитает десятиминутную статью с кодом. Оценку лучше записывать по одинаковым критериям, а не по первому впечатлению.
Подготовка текста: числа, ссылки и ударения
Аудиосценарий может отличаться от печатной статьи. Вместо длинного URL лучше сказать «ссылка есть в тексте», вместо блока кода — объяснить его назначение. Числа с единицами измерения и сокращения иногда стоит раскрывать словами: «512 МБ» превратить в «пятьсот двенадцать мегабайт». Исходную публикацию ради этого менять не обязательно.
Уберите элементы навигации, подписи кнопок и HTML-теги. Таблицу обычно лучше пересказать: сначала назвать критерий, затем сравнить варианты. Длинный материал разбивайте по смысловым разделам, чтобы правка одного абзаца не требовала заново оплачивать весь файл.
Для управления произношением некоторые API поддерживают SSML — разметку синтеза речи с паузами и другими подсказками. Поддержка отличается у провайдеров и версий: в документации SpeechKit SSML относится к API v1. Не переносите разметку и параметры между сервисами без проверки. Даже правильно размеченный результат нужно прослушать.
Сколько стоит озвучить статью
Не все сервисы считают одинаково. Возможны оплата за символы, запросы, кредиты или пакет подписки. Минуты готового аудио зависят от темпа и пауз, поэтому цену «за тысячу символов» нельзя напрямую приравнять к цене минуты.
У SpeechKit API v1 на дату проверки указано 1342 ₽ за миллион символов с НДС. Для текста на 8000 тарифицируемых символов один проход даст примерно 10,74 ₽: 8000 × 1342 / 1 000 000. Две полные генерации — около 21,47 ₽. Это расчёт синтеза, без хранения, трафика и других услуг.
У API v3 SpeechKit другая схема: единицы запросов и модели, с учётом блоков по 250 символов при длинном синтезе. Ставку v1 нельзя подставлять в расчёт v3. У ElevenLabs тариф Free включает 10 тысяч кредитов в месяц, а Starter — 30 тысяч за $6 в месяц без налогов. Кредит не всегда равен символу: расход зависит от модели и способа использования. Коммерческая лицензия указана начиная со Starter.
В бюджет включайте повторные генерации. Сначала отработайте произношение сложного названия на короткой фразе, а затем запускайте целый раздел. Для постоянного сайта разумнее хранить утверждённую запись, чем синтезировать ту же статью при каждом прослушивании.
Первый запрос к SpeechKit API: получаем MP3
Ниже — пример для Bash в Linux, macOS или WSL. Он обращается к API v1 от имени сервисного аккаунта. Подготовьте платёжный аккаунт, каталог, сервисный аккаунт с ролью ai.speechkit-tts.user и API-ключ с разрешением на синтез. Рабочий ключ задайте в переменной окружения SPEECHKIT_API_KEY; в статью, Git и браузерный код его вставлять нельзя.
curl --fail --silent --show-error \
  --request POST \
  --header "Authorization: Api-Key ${SPEECHKIT_API_KEY}" \
  --data-urlencode 'text=Эту статью теперь можно не только читать, но и слушать.' \
  --data-urlencode 'lang=ru-RU' \
  --data-urlencode 'voice=filipp' \
  --data-urlencode 'format=mp3' \
  'https://tts.api.cloud.yandex.net/speech/v1/tts:synthesize' \
  --output speech.mp3
Здесь voice задаёт поддерживаемый голос, format — формат файла. При успешном ответе сервер возвращает бинарное аудио, которое curl сохраняет в speech.mp3. Флаг --fail помогает не принять HTTP-ошибку за успешную генерацию; старый файл с таким именем после неудачи не следует считать новым результатом.
Это пример по документации, а не отчёт о нашем платном тесте: запрос к синтезу мы не выполняли. Для API v1 длина поля text ограничена 5000 символами, тело запроса — 15 КБ. Для большого русского текста учитывайте оба ограничения. При авторизации сервисным аккаунтом поле folderId не передают; у пользовательского IAM-токена правила другие.
Как добавить озвучку на сайт
- Сохранить отдельный аудиосценарий и его версию.
- Отправить задачу на сервер: ключ провайдера остаётся там.
- Сгенерировать части, проверить ошибки и прослушать результат.
- Сохранить утверждённый файл и показать посетителю плеер с запуском по кнопке.
- При изменении текста отметить устаревшую озвучку и обновить нужные фрагменты.
Для ошибок и ограничений нужны контролируемые повторные попытки, а не бесконечный цикл: общий подход есть в статье про rate limit и ошибку 429. Удобно сохранять имя голоса, настройки, версию сценария и расход: тогда понятна причина изменения звука и бюджета.
Если задача — просто прочитать текст посетителю без готового файла, можно рассмотреть браузерный speechSynthesis. Набор голосов зависит от устройства, поэтому одинакового звучания у всех пользователей ждать не стоит. Для стабильной аудиоверсии публикации серверная генерация файла предсказуемее.
Начните с одной статьи и короткого пробного фрагмента. Выберите голос на реальном русском материале, исправьте трудные слова, оцените стоимость с учётом правок и только затем автоматизируйте озвучку. Доступный текст публикации сохраняйте рядом с аудио, а использование выбранного голоса и файла сверяйте с условиями сервиса.
Частые вопросы
TTS, или синтез речи, превращает написанный текст в аудио. Транскрибация решает обратную задачу: получает текст из записи разговора. Это разные функции, даже если они доступны на одной платформе.
Для пробы у некоторых сервисов есть ограниченные бесплатные тарифы. Например, ElevenLabs на дату проверки предлагает 10 тысяч кредитов в месяц на Free, но расход зависит от модели, а коммерческие условия нужно проверять отдельно. Браузерный SpeechSynthesis воспроизводит речь доступными на устройстве голосами и сам по себе не выдаёт MP3.
Для API v1 на 20 октября 2026 года ставка составляет 1342 ₽ за миллион символов с НДС. Один проход текста на 8000 тарифицируемых символов стоит примерно 10,74 ₽. Повторная генерация увеличит расходы; хранение и трафик считаются отдельно.
Поле text в SpeechKit API v1 ограничено 5000 символами, а тело запроса — 15 КБ. Большой материал нужно делить на подходящие фрагменты, учитывая оба ограничения. Деление по смысловым разделам также упрощает исправления.
Источники
- 1.Yandex SpeechKit — синтез речи через API v1https://aistudio.yandex.ru/ru/docs/speechkit/tts/request
- 2.Yandex SpeechKit — авторизация сервисным аккаунтомhttps://aistudio.yandex.ru/ru/docs/speechkit/concepts/auth
- 3.Yandex SpeechKit — доступные голосаhttps://aistudio.yandex.ru/ru/docs/speechkit/tts/voices
- 4.Yandex SpeechKit — правила тарификацииhttps://aistudio.yandex.ru/ru/docs/speechkit/pricing
- 5.Yandex SpeechKit — поддержка SSMLhttps://aistudio.yandex.ru/ru/docs/speechkit/tts/markup/ssml
- 6.SaluteSpeech — способы синтеза речиhttps://developers.sber.ru/docs/ru/salutespeech/guides/synthesis/synthesis-ways
- 7.ElevenLabs — актуальные модели и поддержка языковhttps://elevenlabs.io/docs/overview/models
- 8.ElevenLabs — тарифы, кредиты и коммерческая лицензияhttps://elevenlabs.io/pricing
- 9.MDN — SpeechSynthesis и голоса на устройствеhttps://developer.mozilla.org/en-US/docs/Web/API/SpeechSynthesis