Fine-tuning или RAG — выбор, который возникает, когда обычная модель плохо справляется с задачами компании. Одной не хватает свежих сведений о товарах, другая знает факты, но отвечает в неподходящем формате. Эти проблемы похожи снаружи, однако требуют разных изменений в системе.
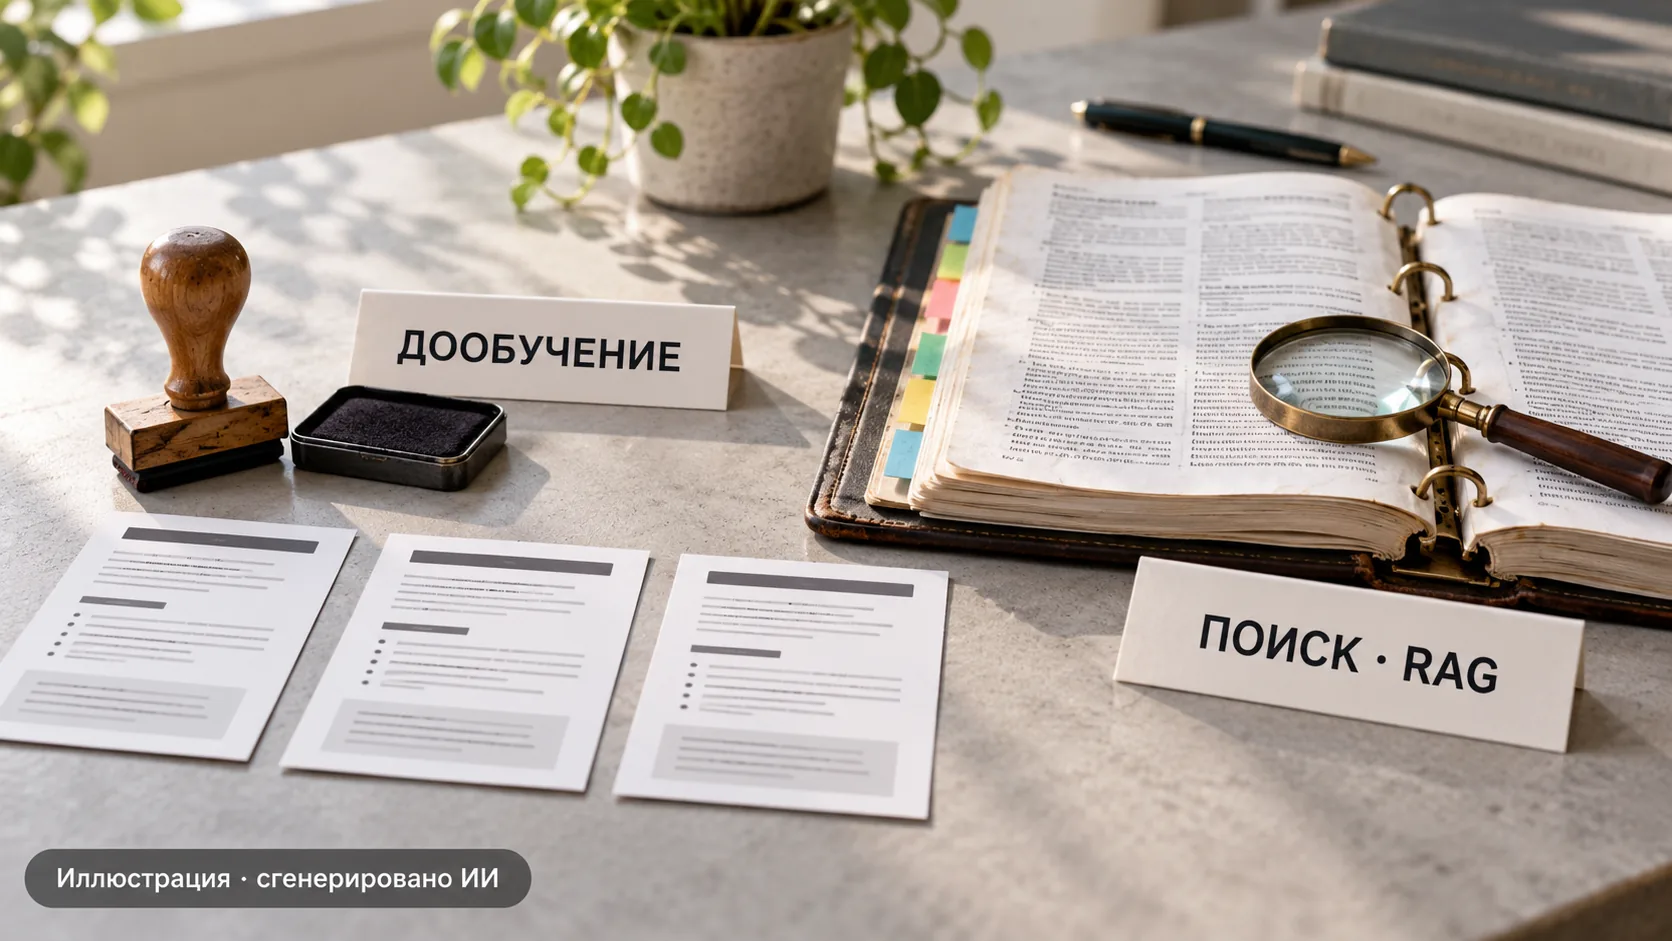
Fine-tuning, или дообучение, меняет поведение модели на основе обучающих примеров. RAG — генерация с предварительным поиском материалов — даёт ей нужные сведения во время запроса. Разберём, когда полезен каждый подход, почему их можно сочетать и как проверить результат до дорогого внедрения.
Что меняется при дообучении, а что — при RAG
При дообучении уже подготовленную модель адаптируют на дополнительном наборе данных. Например, показывают обращения покупателей и правильные ответы с нужной структурой. Обновляются параметры модели либо обучаемого адаптера; затем полученную версию используют для новых запросов.
В схеме RAG приложение сначала ищет подходящие документы: правила возврата, описание услуги, инструкцию или фрагменты базы знаний. Найденные материалы передаются модели вместе с вопросом. Для такого подключения не обязательно менять веса генератора. Базовый механизм разобран в статье «Что такое RAG простыми словами».
Полезный ориентир: дообучение чаще помогает с повторяемым способом выполнения задачи, а поиск — с доступом к нужным фактам. Это не жёсткое разделение. Модель может усвоить сведения при обучении, а в RAG-системе можно отдельно обучать поиск. Важно понимать, какой именно компонент вы меняете и как будете обновлять его дальше.
Сначала проверьте промпт и примеры
Если модель не соблюдает порядок разделов или пишет слишком длинно, дообучение не должно быть первым действием. Сначала уточните инструкцию, дайте несколько хороших примеров и задайте критерии результата. Такой подход называют few-shot: образцы передаются прямо в запросе. Подробнее — в статье о примерах в промпте.
Для машинного формата полезно проверить поддержку структурированного вывода. Если программа ожидает JSON, обучение «отвечать как JSON» не заменяет разбор и проверку данных. Схемы и валидация описаны в материале о структурированном выводе модели.
Базовый вариант нужен и для сравнения. Без него сложно понять, помогли ли дополнительные данные и инфраструктура или ту же задачу можно было решить короткой инструкцией. Фиксируйте версию модели, исходный запрос и тестовые примеры, чтобы сравнение не превратилось в оценку случайных ответов.
Когда разумно начинать с RAG
Поиск особенно полезен, когда ответ должен опираться на документы, которые регулярно меняются. Например, магазину нужно объяснять действующие условия доставки. Если тариф обновили вчера, удобнее заменить документ и проверить индекс, чем запускать обучение ради новой цифры.
RAG также помогает показать источник ответа. Но ссылка не появляется правильно сама собой: приложение должно сохранять адрес и версию материала, передавать их модели и проверять соответствие вывода найденному фрагменту. Наличие поискового слоя не гарантирует отсутствие выдумок.
- База поддержки. Ответы по действующим инструкциям, с переходом к исходному разделу.
- Каталог документов. Поиск нужной спецификации или версии описания.
- Внутренний справочник. Работа с материалами, доступ к которым зависит от пользователя.
- Частые изменения. Обновление сведений без переобучения генератора при каждой правке.
Если поиск не нашёл важное исключение из правила, модель его не увидит. Ошибку нужно искать по цепочке: правильно ли извлечён текст, удачно ли выделены фрагменты, попал ли нужный раздел в результаты. При работе с документами пригодится статья о чанкинге для RAG.
Когда стоит рассмотреть fine-tuning
Дообучение имеет смысл, если задача повторяется, правильное поведение можно описать примерами, а более простой вариант не даёт достаточного качества. В документации Google среди задач supervised fine-tuning — обучения на размеченных примерах — названы классификация, суммаризация и ответы на вопросы.
Практический пример — распределять обращения по собственным категориям компании. Или превращать однотипные заметки сотрудника в стандартизированное описание с определённым уровнем подробности. Здесь важен устойчивый способ обработки входа, а не запоминание сегодняшнего остатка на складе.
Для обучения нужны согласованные образцы. Если один редактор отвечает кратко, другой развёрнуто, а правила категоризации меняются внутри датасета, модель получит противоречивую цель. Большое количество таких записей не исправляет их качество. Сначала договоритесь, что считается правильным результатом.
Не все модели и платформы поддерживают дообучение. Нужно проверить доступный способ адаптации, форматы данных, регионы и условия развёртывания. Подробности провайдеров меняются; возможности в статье сверены с официальной документацией 22 октября 2026 года. Универсальной цены за «дообучение любой модели» нет.
Сравнение: знания, стиль, обновления и источники
| Критерий | RAG | Fine-tuning |
|---|---|---|
| Основное изменение | Материалы, которые модель получает при ответе | Параметры модели или обучаемого адаптера |
| Новые правила и цены | Обновление документов и поискового индекса | Новая адаптация и проверка версии, если сведения хранились в модели |
| Повторяемый формат | Инструкции и образцы можно передать вместе с данными | Можно обучать устойчивому поведению на примерах |
| Проверяемый источник | Можно связать ответ с найденным документом | Само обучение не даёт происхождение каждого утверждения |
| Типичная причина ошибки | Не найден или неверно выбран нужный фрагмент | Некачественные примеры, слабое обобщение или устаревшие сведения |
| Что обслуживать | Документы, поиск, права доступа и генерацию | Датасет, обучение, версии модели и развёртывание |
Эта таблица помогает выбрать направление эксперимента, но не определяет победителя для любой задачи. Для обзора целого небольшого документа иногда проще передать его полностью, чем извлекать отдельные части. Когда подходит такой вариант, объясняем в статье о контекстном окне модели.
LoRA: дообучение без изменения всех весов
LoRA — один из способов экономной адаптации. Вместо обновления всех исходных весов обучаются дополнительные небольшие матрицы, а базовые веса остаются фиксированными. Во время работы используются базовая модель и полученные изменения; при подходящей реализации адаптер можно объединить с весами.
Это уменьшает объём обучаемых параметров, но не делает подготовку данных бесплатной и не отменяет проверку качества. Базовая модель всё равно нужна для запуска. Совместимость адаптера с версией модели и движком нужно контролировать отдельно.
LoRA также не следует путать с квантизацией. Квантизация уменьшает точность представления чисел, а дообучение адаптирует модель к задаче. Методы могут сочетаться, но решают разные проблемы. Форматы и сжатие разобраны в статье о GGUF и квантизации.
Как сравнить варианты на своей задаче
Соберите отдельный набор проверок, который не участвует в обучении и настройке. Добавьте типичные обращения, редкие исключения, неоднозначные вопросы и случаи, когда правильный ответ — запросить уточнение. Одинаковые или почти одинаковые примеры в обучении и проверке дадут слишком оптимистичную оценку.
- Проверьте базовую модель с ясной инструкцией и несколькими примерами.
- Для вопросов по документам добавьте поиск и оцените, находит ли он правильный источник.
- Если остаётся повторяемая ошибка поведения, испытайте дообучение на качественных образцах.
- При необходимости проверьте сочетание дообученной модели и поиска.
- Сравните правильность, источники, формат, отказы, задержку и стоимость завершённой задачи.
Это план эксперимента, а не отчёт о проведённом нами тесте. Оценивайте также ошибки после обновления данных: замените одно правило в справочнике и проверьте, перестала ли система возвращать старый вариант. Такой тест часто полезнее сравнения двух эффектных демонстрационных ответов.
Можно ли объединить RAG и дообучение
Да. Например, поиск предоставляет действующие условия доставки, а адаптированная модель формирует ответ в нужной структуре: краткий вывод, основание, оговорки и ссылка. Свежие факты остаются во внешних материалах, а повторяемый способ ответа закрепляется примерами.
Порядок здесь важен. Если генератор получает неверные документы, обучение хорошему стилю только сделает ошибку убедительнее. Сначала отделите ошибку поиска от ошибки интерпретации и оформления. Иногда полезнее улучшить отбор фрагментов, чем трогать генератор.
Как считать расходы и выбрать первый шаг
Для RAG учитывайте обработку документов, построение и хранение индекса, поиск, дополнительный вход модели и обслуживание обновлений. Для дообучения — разметку и очистку примеров, тренировочные прогоны, хранение версий, размещение модели и повторные проверки. Точность сравнения важнее красивой цены одного запроса.
Отдельно предусмотрите доступ к данным. Документы для разных пользователей нельзя смешивать в выдаче без проверки прав. Секреты не стоит включать в обучающие примеры; удаление записи из датасета не отменяет автоматически уже проведённое обучение. В обоих подходах нужны проверяемые версии данных и понятный откат.
Если не хватает актуальных сведений — начните с источников и поиска. Если не хватает устойчивого навыка — с инструкции, примеров и затем, при необходимости, дообучения. Выбирайте сложность после измерения ошибки. RAG и fine-tuning могут дополнять друг друга, но ни один из них не заменяет качественные данные и проверку результата.
Частые вопросы
Дообучение адаптирует параметры модели или обучаемого адаптера на примерах. RAG ищет нужные материалы и передаёт их модели при ответе; менять веса генератора для этого не обязательно.
Если ответы должны опираться на действующие документы, регулярно меняющиеся правила и проверяемые источники. Нужно отдельно оценивать качество поиска, актуальность материалов и правильность ответа.
Нет. Сначала стоит проверить ясную инструкцию, несколько хороших примеров и поддержку структурированного вывода. Если повторяемая ошибка остаётся и есть качественный датасет, можно сравнить дообучение с базовым вариантом.
Да. Например, поиск предоставляет актуальные условия услуги, а адаптированная модель оформляет ответ в нужной структуре. Ошибки поиска и генерации проверяют отдельно.
Источники
- 1.AWS — сравнение RAG и fine-tuninghttps://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/rag-vs-fine-tuning.html
- 2.Google Cloud — supervised fine-tuning и примеры задачhttps://docs.cloud.google.com/gemini-enterprise-agent-platform/models/tuning/supervised-tuning
- 3.Hugging Face PEFT — LoRA и обучение адаптеровhttps://huggingface.co/docs/peft/main/conceptual_guides/lora
- 4.LoRA — оригинальная исследовательская работаhttps://arxiv.org/abs/2106.09685
- 5.RAG — оригинальная работа о поиске и генерацииhttps://arxiv.org/abs/2005.11401