Google объявила о планах поддержать общий сигнал в robots.txt, которым владельцы сайтов смогут выражать отказ от использования контента для обучения ИИ. Анонс опубликован 30 октября 2026 года. Вместо отдельного правила для каждой участвующей компании предлагается одна группа с токеном __usage_ai-training.
Главная оговорка: это ещё не универсальный работающий переключатель. Google планирует поддержку в 2027 году, а техническое предложение пока имеет статус черновика. Для владельцев сайтов новость важна как изменение будущих правил управления контентом, но действующие настройки обхода и использования материалов пока сохраняют значение.
Что именно предложено
Обычно robots.txt адресует правила определённому роботу. Новый механизм использует строку User-agent для обозначения цели использования: обучение ИИ. В опубликованном проекте это называется policy token — токен политики. Он не является названием нового краулера, который непременно появится в серверных логах.
Технический документ Machine-Readable Training Preference Signal опубликован 30 октября Кевином Келли из Anthropic. Это индивидуальный Internet-Draft в системе IETF. Карточка документа прямо предупреждает, что он не одобрен IETF и пока не имеет формального статуса в процессе стандартизации. Поэтому называть предложение уже принятым интернет-стандартом преждевременно.
Для записи используются знакомые Allow и Disallow; отдельная новая директива не вводится. Правила привязывают предпочтение к путям сайта. Идея — позволить издателю один раз описать выбор для нескольких поддерживающих механизм компаний.
Как выглядит правило в robots.txt
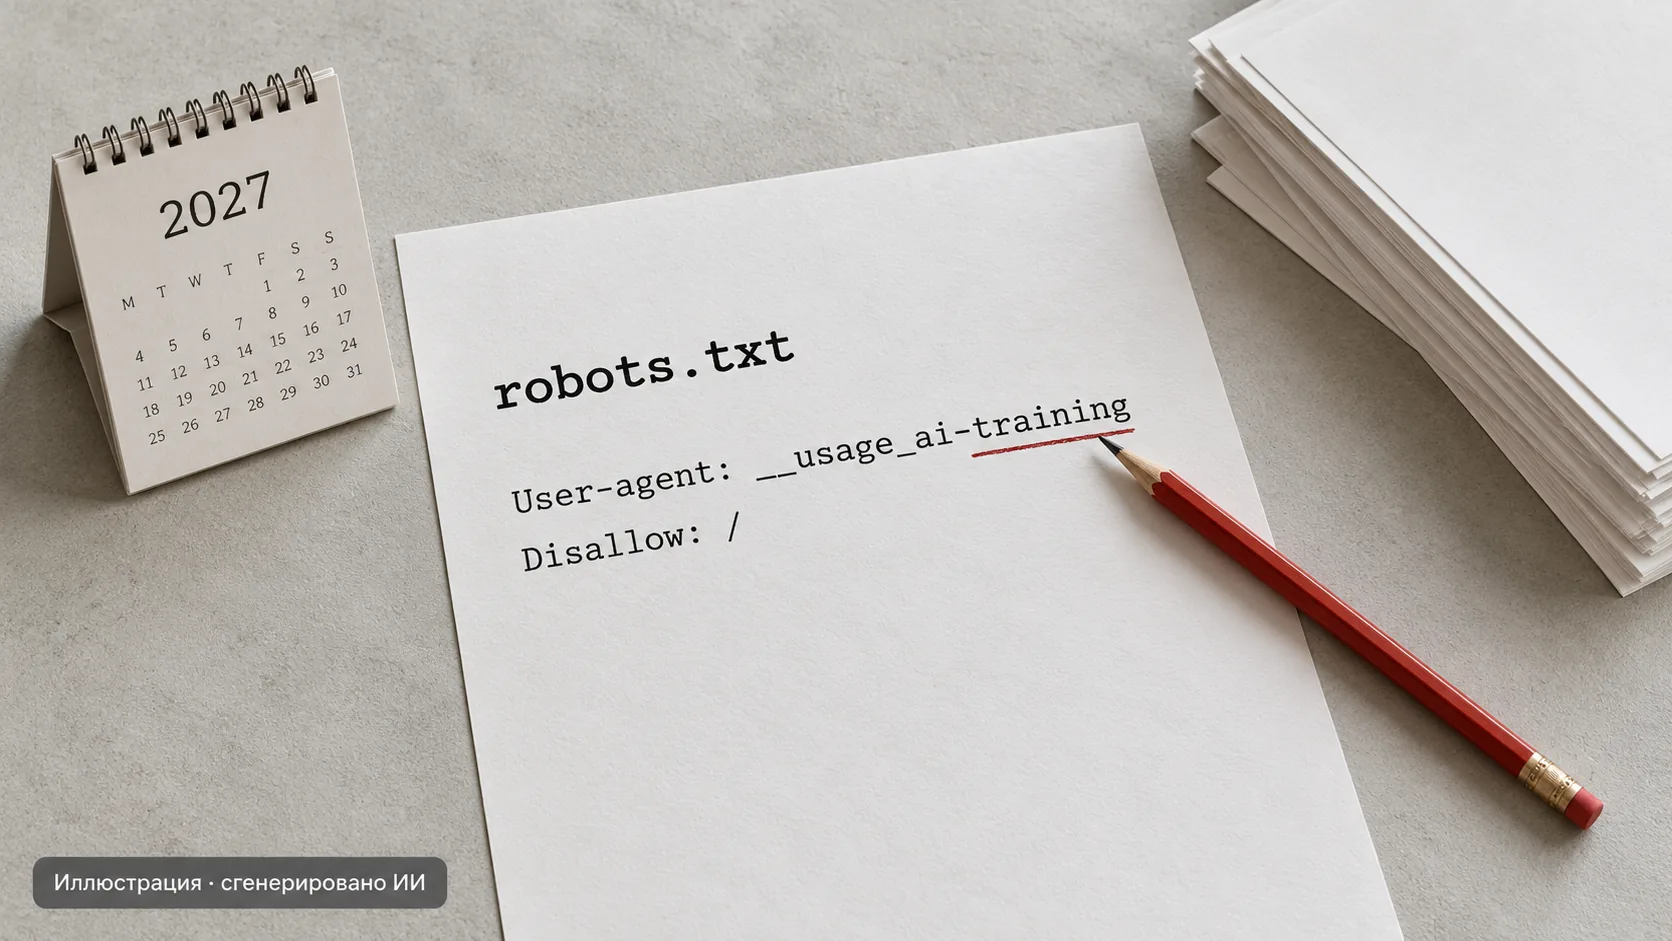
Самый короткий пример отказа от обучения для всего сайта выглядит так:
User-agent: __usage_ai-training
Disallow: /
Вариант с исключением для специально подготовленного раздела:
User-agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Это иллюстрация синтаксиса проекта, а не рекомендация немедленно заменить рабочий robots.txt. Более конкретное правило пути позволяет задать исключение. При этом обычная группа User-agent: *, согласно проекту, не считается совпадением с токеном политики: для выражения этого предпочтения нужна явная строка с его именем.
Отсутствие такой группы означает отсутствие предпочтения через данный механизм. Это не вывод о любых других ограничениях сайта, условиях договоров или настройках конкретной платформы.
Когда Google начнёт его учитывать
В блоге Search Central Google называет 2027 год. В документации о краулерах срок уточнён до начала 2027 года. Точной даты запуска компания не указывает. На 31 октября объявление следует читать как план поддержки, а не как подтверждение, что новый сигнал уже действует в сервисах Google.
По описанию компании, если сайт запрещает обучение через общий токен и отдельно не задаёт Google-Extended, Google планирует трактовать такой выбор как запрет Google-Extended. Действующие правила для конкретной компании продолжат работать рядом с общим механизмом.
Практический смысл — общий выбор плюс возможность отдельных настроек. Но перед изменением файла надо смотреть итоговую документацию провайдера: именно она объясняет, что произойдёт при сочетании общего сигнала и его собственных правил.
Google-Extended связан не только с обучением
В актуальной документации Google-Extended управляет использованием полученного Google контента для обучения будущих моделей Gemini и для grounding в определённых ИИ-сервисах. Grounding — это предоставление модели найденного материала во время ответа, чтобы опереться на внешние сведения. Это отличается от изменения самой модели в ходе обучения.
Поэтому нельзя обещать, что предлагаемое сопоставление общего токена с Google-Extended затронет исключительно обучение и ничего больше. Владельцу, которому важны переходы из ответов Gemini, стоит отдельно изучить область действия Google-Extended. В блоге Google говорит о возможности участия разрешённых сайтов в grounding, но это не гарантия цитирования или трафика.
Google также указывает, что Google-Extended не влияет на включение сайта в Google Search и не используется как сигнал ранжирования. Это не повод блокировать Googlebot, если цель ограничена использованием контента для ИИ: у этих настроек разные назначения.
Microsoft тоже разделяет обучение и ответы
В собственном анонсе от 30 октября Microsoft поддержала общий подход и описала независимые предпочтения для обучения и grounding. Компания планирует начать учитывать новые настройки по мере обхода страниц с 1 февраля 2027 года.
Для сайтов, использующих NoArchive или NoCache, Microsoft отдельно описала переходные действия и срок до 1 марта 2027 года. Это дата перехода её собственных механизмов, а не общий срок запуска сигнала во всех компаниях. Владельцам таких сайтов нужно читать полную инструкцию Bing: одной новой строки в robots.txt недостаточно для переноса всех прежних ограничений grounding.
Сам факт согласия с общим направлением не означает одинаковые сроки и одинаковую трактовку всех соседних настроек. Поэтому полезнее вести таблицу по провайдерам, чем считать один токен мгновенной заменой всех существующих правил.
Чего новое правило не делает
| Вопрос | Что важно понимать |
|---|---|
| Закроет ли правило доступ к странице? | Нет: robots.txt не является механизмом авторизации |
| Заставит ли оно любую компанию соблюдать отказ? | Нет: нужно заявленное и реализованное соблюдение со стороны провайдера |
| Удалит ли уже собранные материалы? | Анонс не даёт основания обещать удаление прежних данных |
| Заменяет ли оно noindex? | Нет: предпочтение обучения и включение страницы в поиск — разные вопросы |
| Начинает ли оно работать сразу после записи? | Нет: важны внедрение поддержки и получение правил провайдером |
RFC 9309, описывающий robots.txt, прямо отделяет правила для автоматических клиентов от авторизации доступа. Для закрытых документов нужны ограничения на стороне сервера. Размещение чувствительного файла на публичном URL с запретом в robots.txt не превращает его в приватный.
Что владельцу сайта стоит сделать сейчас
Сначала определите цель: ограничить обучение, участие в ответах ИИ или вообще публичный доступ. Эти задачи требуют разных механизмов. Желание получать переходы из ИИ-поиска тоже лучше учитывать явно, а не считать его автоматическим следствием любой разрешающей настройки.
Сохраните текущий robots.txt и выпишите имеющиеся правила для поисковых и ИИ-роботов. Отдельно проверьте общую группу со звёздочкой: случайный Disallow для всех клиентов может оказаться гораздо шире исходной задачи. Новое правило должно дополнять продуманную политику, а не стирать предыдущую конфигурацию.
Затем запишите в рабочий план даты повторной проверки документации Google и других нужных провайдеров. При внедрении проверьте опубликованный файл, путь его получения, код ответа и отсутствие случайных изменений правил поиска. Не ждите от журнала запросов прямого доказательства, что страница использована или не использована для обучения.
Общий сигнал может сократить число отдельных правил для участвующих компаний. Пока главная польза анонса — появление согласованного направления и понятного синтаксиса для обсуждения. Для действующего сайта разумно сохранить рабочие настройки и готовить изменения по мере подтверждённого запуска поддержки.
Разницу между видимостью в обычном поиске и использованием источников в ответах ИИ мы разбирали в статье про GEO-оптимизацию. А если задача состоит именно в закрытии лишних страниц WordPress от индексации, пригодится отдельный разбор страниц вложений.
Частые вопросы
В анонсе от 30 октября 2026 года указан 2027 год; документация краулеров уточняет начало 2027 года. Точной даты нет. На 31 октября это план поддержки, а не уже действующий универсальный переключатель.
В проекте используется группа User-agent: __usage_ai-training с обычными Allow и Disallow. Например, Disallow: / выражает отказ от обучения для всего сайта через этот механизм. Поддержка зависит от провайдера.
Нет. На момент проверки это индивидуальный Internet-Draft draft-kelley-aipref-training-preference-signal-00 от 30 октября 2026 года. Карточка прямо указывает, что документ не одобрен IETF и не имеет формального статуса в процессе стандартизации.
Нет. Google указывает, что Google-Extended не влияет на включение в Search или ранжирование, но управляет также grounding в определённых ИИ-сервисах. Планируемое сопоставление общего отказа с Google-Extended нужно оценивать с учётом этой области действия.
Источники
- 1.Google: анонс общего сигнала от 30 октябряhttps://developers.google.com/search/blog/2026/10/ai-training-control
- 2.Google: Google-Extended и срок поддержки AIPREFhttps://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers
- 3.IETF: текст индивидуального проекта Training Preference Signalhttps://www.ietf.org/archive/id/draft-kelley-aipref-training-preference-signal-00.html
- 4.IETF Datatracker: статус индивидуального Internet-Drafthttps://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
- 5.Microsoft Bing: обучение, grounding и сроки внедренияhttps://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/
- 6.RFC 9309: Robots Exclusion Protocolhttps://www.rfc-editor.org/rfc/rfc9309.html